İç içe kayıtlar ve küçük veri işleme
Geçen hafta bir ürünün ad, fiyat, stok bilgilerini bir sözlükte tutmayı gördük. Elimizde birden fazla ürün ya da öğrenci varsa her kaydı bir sözlüğe koyar, bu sözlükleri de bir listede saklarız.
Bu hafta yeni bir Python yapısı öğrenmeyeceğiz. Bildiğimiz liste, sözlük, koşul, döngü ve fonksiyonları birlikte kullanarak küçük veri kümeleriyle çalışacağız. Dört iş yapacağız: koşula uyan kayıtları seçmek (filtreleme), toplam ve ortalama almak (özetleme), en yüksek değerli kaydı bulmak (maksimum arama) ve kayıtları bölüm gibi bir alana göre ayırıp her grubu saymak ya da bir listede toplamak (gruplama).
Bu sayfadaki kod hücreleri kendiliğinden çalışmaz. Her hücrede önce çıktıyı tahmin edin, sonra Run Code düğmesine basın. Kodu değiştirip yeniden çalıştırabilir, Start Over ile ilk hâline döndürebilirsiniz.
Bu bölümün kapsamı
liste[indeks]["alan"]erişiminin iki adımı- Filtreleme kalıbı ve
append()in kaydı kopyalamaması - Kayıtlar üzerinde sayma ve biriktirme ile özet çıkarma
- Maksimum aramada en büyük değerin ait olduğu kaydı tutma,
Noneile başlayan kalıptaorkısa devresi - Kayıtları bir alana göre gruplama: her grubun sayısı, toplamı ya da kayıt listesi
- Metin alanlarını normalleştirmenin gruplama sonucunu nasıl değiştirdiği
- Kayıt listesinde eksik alanın toplama ve ortalamaya etkisi, varsayılan değeri problemin kuralına göre seçme
- Veri çerçevesi (tablo biçiminde veri tutan yapı) kullanan kütüphaneler
- İkiden çok seviyeli iç içe yapıların derin kopyası (içteki nesnelerin de kopyalanması)
Bu başlıklar konunun devamıdır. İleride karşınıza çıkar, ama bu derste ezberlemeniz beklenmiyor.
Liste içinde sözlükler
Bir öğrenci kaydı:
ogrenci = {
    "ad": "Deniz",
    "bolum": "Bilgisayar",
    "puan": 78
}
Birden fazla öğrenciyi bir listede tutarız. Burada dış yapı bir liste, her eleman bir sözlüktür. Sözlükteki her anahtar-değer çifti kaydın bir alanıdır: ad, bolum, puan. Hücrenin son satırı ne yazar?
Python önce listenin 0 numaralı elemanını, yani ilk sözlüğü alır. Sonra o sözlüğün "puan" alanını okur.
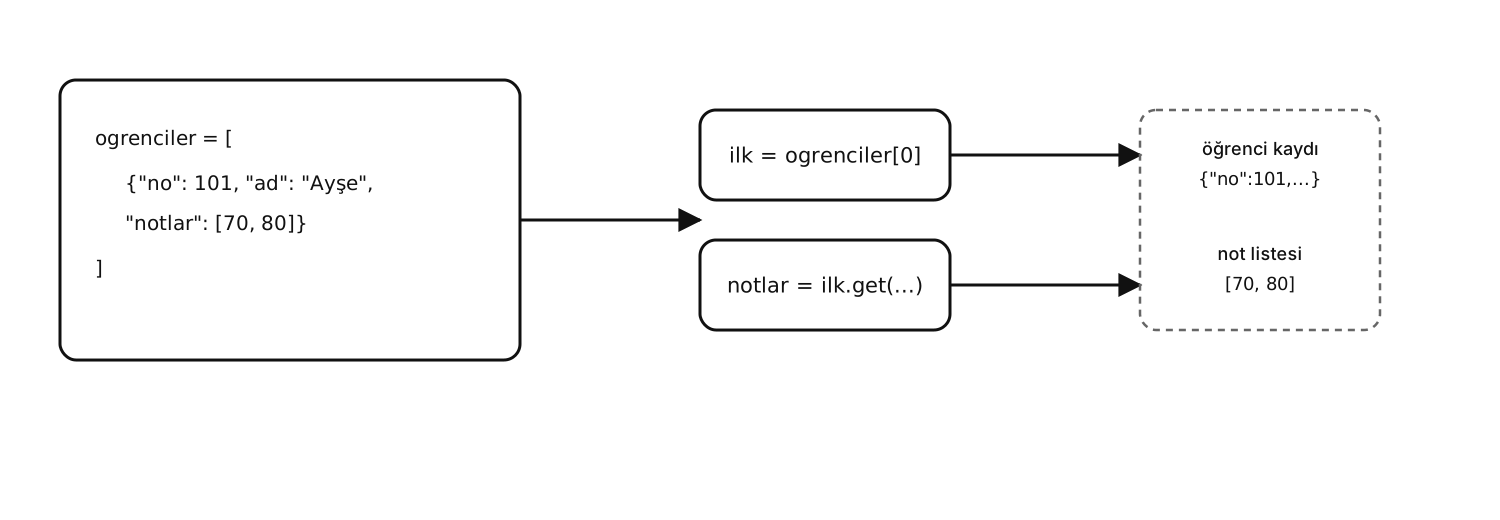
Uzun bir erişimi tek bakışta çözmeye çalışmayın, soldan sağa parça parça okuyun. ogrenciler[1]["puan"] için:
ogrenciler[1]→ ikinci öğrenci sözlüğü["puan"]→ o sözlükteki puan değeri
Hücreye print(ogrenciler[1]["ad"]) satırını ekleyip çalıştırmadan önce ne yazacağını söyleyin.
Kayıtlar üzerinde gezinmek
Döngünün her turunda ogrenci değişkeni listedeki sıradaki sözlüğü gösterir. Hücre kaç satır yazar?
Bu bölümdeki programların çoğu aynı sırayla çalışır:
kayıt listesi
    ↓
her kaydı sırayla al
    ↓
alanlarını oku
    ↓
koşula göre işle
Tahmin et: hangi kayıtlar yazılır?
Hücre hangi ürün adlarını yazar? Önce tahmin edin, sonra çalıştırın.
Koşula uyan kayıtları böyle seçmeye filtreleme denir.
Koşul yalnız stoku 0 olan ürünlerde doğrudur. Defter ve Cetvel yazılır. Yazılan da sözlüğün tamamı değil, yalnız ad alanıdır.
Filtreleme: koşulu sağlayan kayıtları seçmek
Seçilen kayıtları yazdırmak yerine yeni bir listede toplayabiliriz. gecenler listesinde hangi öğrencilerin kaydı bulunur?
gecenler listesine yalnız puanı 60 ve üzeri olan kayıtlar girer.
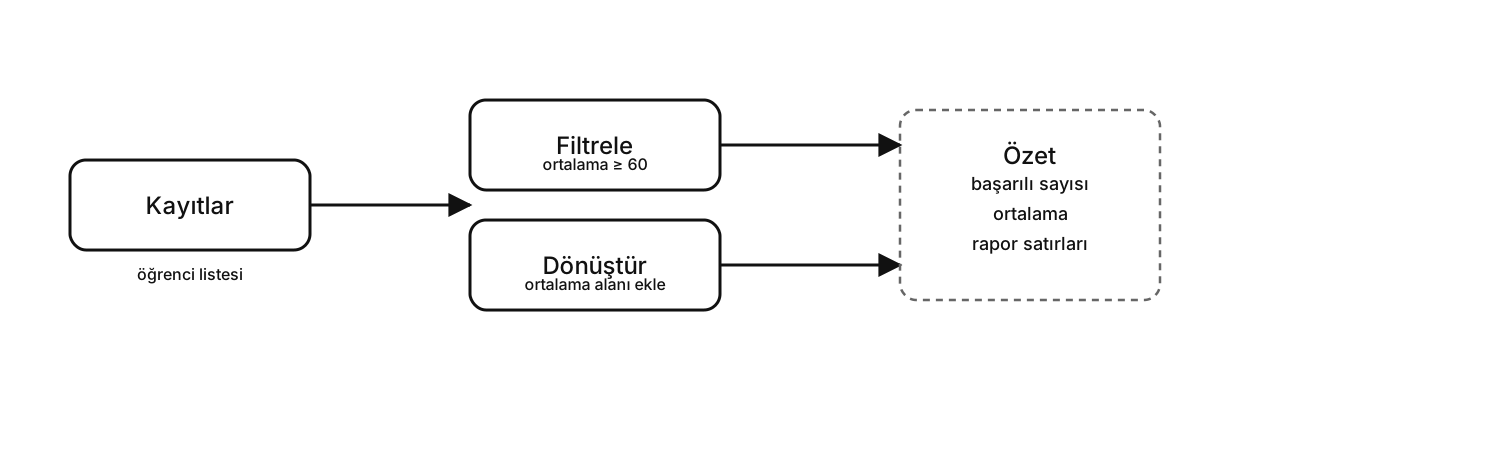
Filtrelenen sözlükler kopyalanmaz
9. bölümde gördüğümüz aliasing (iki adın aynı nesneyi göstermesi) burada yine karşımıza çıkıyor. gecenler.append(ogrenci) yeni bir sözlük oluşturmaz. Listeye var olan sözlüğü gösteren bir bağ ekler. Bu bağa referans denir.
Aşağıdaki kod yalnız gecenler listesindeki ilk kaydın puanını değiştiriyor. Son satır ne yazar?
Çıktı 0’dır. gecenler[0] ile ogrenciler[0] aynı sözlük nesnesini gösterir. Bu yüzden gecenler üzerinden yapılan değişiklik ogrenciler listesinden de görünür.
Asıl kaydı değiştirmeden ayrı bir kayıt istiyorsanız listeye sözlüğün sığ kopyasını (shallow copy) ekleyin. Sığ kopya, sözlüğün kendisini kopyalayan ama içindeki değerleri paylaşan kopyadır:
gecenler.append(ogrenci.copy())Hücrede append(ogrenci) satırını append(ogrenci.copy()) yapıp yeniden çalıştırın. Son satır ne yazar?
.copy() yalnızca sözlüğün kendisini kopyalar. Sözlüğün içinde liste gibi değiştirilebilir bir değer varsa o değer iki kopya arasında ortak kalır. Bu bölümdeki kayıtlarda değerler yalnızca sayı ve metin olduğu için sığ kopya yeterlidir.
Alıştırma: düşük stok kayıtlarını seçin
Stoku 5 ve altında olan ürünleri dusuk_stok listesine ekleyin. Listede Defter ve Silgi kayıtları bulunmalıdır.
if urun["stok"] <= 5: koşulu içinde dusuk_stok.append(urun) kullanabilirsiniz.
urunler = [
    {"ad": "Kalem", "stok": 12},
    {"ad": "Defter", "stok": 3},
    {"ad": "Silgi", "stok": 5},
    {"ad": "Cetvel", "stok": 8}
]

dusuk_stok = []

for urun in urunler:
    if urun["stok"] <= 5:
        dusuk_stok.append(urun)

print(dusuk_stok)
Özetleme: toplam ve ortalama
Her kaydın aynı alanını bir değişkende toplayabiliriz. Döngünün her turunda bir değişkene ekleyerek toplam tutmaya biriktirme denir. Hücre ne yazar?
Ortalama için toplam / len(satislar) yazabiliriz. Ama liste boşsa len(satislar) sıfır olur ve bölme ZeroDivisionError verir. Bu durumu ayrıca düşünmek gerekir.
Boş liste için ortalama ne döndürmeli?
Boş bir öğrenci listesinde ortalama olarak 0 döndürmek ilk bakışta makul görünebilir. Ama şu iki durum birbirinden farklıdır:
[]: hiç puan yok.[{"ad": "Ece", "puan": 0}]: bir öğrenci var ve puanı gerçekten0.
İkisinde de 0 döndürürsek aradaki fark kaybolur. Bu yüzden fonksiyonun sözleşmesine (7. bölümde gördüğümüz, fonksiyonun ne alıp ne döndüreceğini söyleyen yazılı not) boş liste için ayrı bir kural koyuyoruz:
Çıktı:
- liste boşsa None: hesaplanabilecek ortalama yok
- değilse puanların sayısal ortalaması
Fonksiyonu çağıran kod bu durumu kontrol eder. Bunun için is operatörünü kullanırız. is, iki tarafın aynı nesne olup olmadığını sınar. 9. bölümde b = a atamasından sonra a ile b aynı listeyi gösteriyordu; orada a is b yazsaydık sonuç True olurdu. Programda tek bir None nesnesi vardır ve None döndüren her fonksiyon o nesneyi döndürür. Bu yüzden bir değerin None olup olmadığı x is None diye sınanır. Hücre ne yazar? Sonra puan_ortalamasi([]) çağrısını puan_ortalamasi([{"ad": "Ece", "puan": 0}]) yapıp yeniden çalıştırın.
None değerini 6. bölümde gördük: hiçbir return satırı çalışmayan fonksiyon None döndürür. Burada ise fonksiyon None değerini bilerek döndürüyor. Bir fonksiyonun sorunu None döndürerek bildirmesinin artılarını ve eksilerini 13. bölümde konuşacağız. Bu bölümde şu kural yeter: veri yoksa sonuç bir sayı olmamalı.
Maksimum arama: yalnızca değeri değil, kaydı bulmak
9. bölümde bir sayı listesinde “şimdiye kadarki en yüksek” değeri tutan kalıbı gördük. Kayıtlarda aynı kalıpla en yüksek puanın ait olduğu sözlüğü buluruz. Hücre ne yazar?
Fonksiyon Ayşe’nin kaydını, yani {'ad': 'Ayşe', 'puan': 92} sözlüğünü döndürür. en_yuksek her güncellendiğinde sayının değil, kaydın tamamının yerini alır. Bu yüzden sonuçta ad da vardır.
Koşulda > kullandığımız için eşit puanlı bir kayıt en_yuksek’in yerini almaz: iki öğrencinin puanı eşitse ilk bulunan kayıt kalır.
Başlangıç değeri olarak None
Aynı kalıbı listenin ilk elemanını ayrıca almadan da yazabiliriz. en_yuksek işe None ile başlar, yani “henüz hiç kayıt görmedik” der. Hücre ne yazar? Sonra ogrenciler listesini [] yapıp yeniden çalıştırın.
İlk turda en_yuksek henüz None’dır. Python None["puan"] okumaya kalksaydı TypeError çıkardı. Çıkmaz, çünkü or önce sol tarafa bakar: sol taraf doğruysa sonuç zaten doğrudur ve Python sağ tarafı hiç hesaplamaz. Buna kısa devre denir. İlk turda en_yuksek is None doğru olduğu için Deniz’in kaydı alınır. Sonraki turlarda sol taraf yanlıştır ve puanlar karşılaştırılır. Liste boşsa döngü hiç dönmez ve en_yuksek None kalır: boş liste için ayrıca if yazmak gerekmez.
14. bölümde “en çok ciro yapan ürün”ü bulurken de bu kalıbı kullanacağız.
max() bir sayı listesindeki en büyük değeri tek satırda bulur. Veri sözlüklerden oluşuyorsa başlangıçta döngüyü kendiniz yazın. Böylece hangi alanın karşılaştırıldığını ve hangi kaydın tutulduğunu kodda açıkça görürsünüz.
Alıştırma: toplam stok fonksiyonu
Döngüde her ürünün stok değerini toplama ekleyin. Beklenen sonuç 20’dir.
Döngü içinde toplam = toplam + urun["stok"] yazabilirsiniz.
def toplam_stok(urunler):
    toplam = 0

    for urun in urunler:
        toplam = toplam + urun["stok"]

    return toplam
Basit gruplama
Kayıtları bir alana göre gruplamak için sözlük kullanırız. Aşağıdaki kod her bölümde kaç öğrenci olduğunu sayar: bölüm adı anahtar, öğrenci sayısı değer olur. Hücre ne yazar?
10. bölümde bir listedeki şehirlerin kaç kez geçtiğini (frekansını) böyle saymıştık. Burada aynı kalıbı kayıtların bir alanına uyguluyoruz. Bir bölüm ilk kez geldiğinde sözlükte henüz yoktur ve get(bolum, 0) 0 döndürür.
Gruplama anahtarı gerçekten aynı mı?
Metin alanlarını anahtar yaptığımızda "Siber", "siber" ve " Siber " sözlük için üç ayrı anahtardır. Aşağıdaki sözlükte kaç anahtar olur?
Üç yazım aynı bölümü anlatıyorsa önce hepsini aynı biçime getiren açık bir kural koymalısınız. Buna normalleştirme denir. anahtar = bolum satırını şöyle değiştirip yeniden çalıştırın:
anahtar = bolum.strip().lower()Veride Türkçe harf yoksa bu yeterli olabilir. Ama 8. bölümde gördüğümüz gibi lower(), Türkçe I ve İ harflerini Türkçe kurala göre küçültmez: "KIRTASİYE".lower() sonucu "kırtasiye" olmaz. "İdari" ile "IDARI" gibi yazımların aynı sayılıp sayılmayacağına siz karar verirsiniz.
Gruplamadan önce “biraz temizleyelim” diye her değere körlemesine lower() uygulamayın. Hangi yazımların aynı sayılacağına siz karar vermelisiniz. Türkçe ad, bölüm, ürün ve şehir adlarında 8. bölümdeki normalleştirme uyarısını hatırlayın.
Her grubun toplamını bulmak
Aynı kalıpla her grubun kayıt sayısı yerine tutarlarının toplamını da tutabiliriz. Hücre ne yazar?
Sayarken get() sonucuna 1, toplarken kaydın tutar alanı eklenir. Geri kalan her şey aynıdır.
Her grubun kayıtlarını listede toplamak
Bazen her grupta kaç kayıt olduğu yetmez, o gruptaki kayıtların kendisi gerekir: Siber bölümündeki öğrencilerin adlarını sırayla yazdırmak gibi. Bu kez sözlüğün her değeri bir listedir. Bölüm adı anahtar, o bölümdeki öğrencilerin adları değer olur. Bir bölüm ilk kez geldiğinde sözlükte onun listesi henüz yoktur: önce boş bir liste koyarız, sonra adı o listeye ekleriz. Hücre ne yazar?
İlk satır {'Bilgisayar': ['Deniz', 'Mert', 'Can'], 'Siber': ['Ayşe', 'Ece']} yazar, ikinci satır 3. Deniz geldiğinde "Bilgisayar" anahtarı yoktur: boş liste konur ve Deniz eklenir. Mert geldiğinde liste zaten vardır, if bloğu atlanır ve Mert aynı listeye eklenir. Her listede adlar kayıtların geldiği sırayla durur.
Bu kalıpta iki satırın yeri önemlidir. if bloğunu silerseniz ilk öğrencide gruplar[bolum] okunurken KeyError çıkar. gruplar[bolum] = [] satırını if olmadan her turda çalıştırırsanız her öğrenci kendi bölümünün listesini boşaltır ve her listede yalnız son öğrenci kalır.
Listeye yalnız adı değil kaydın tamamını da ekleyebilirsiniz: gruplar[bolum].append(ogrenci). O zaman, filtrelemede gördüğümüz gibi, listeye kaydın kopyası değil kendisi girer.
Eksik alan ve get()
Bir kayıtta bir alan hiç bulunmayabilir. Aşağıdaki hücrede iki satırdan hangisi hata verir?
İlk satır 0 yazar. İkinci satır KeyError: 'stok' verir, çünkü köşeli parantezle olmayan bir anahtar okunamaz.
get()’in ikinci argümanı, alan yoksa döndürülecek değerdir. Buna varsayılan değer denir. urun.get("stok", 0) hata vermez, 0 döndürür. Ama bu ancak stok bilgisi olmayan ürünün stoku gerçekten sıfır sayılıyorsa doğrudur.
Başka bir problemde eksik alan, verinin hatalı girildiğini gösterebilir. Tutarı yazılmamış bir satış fişine 0 koyarsanız fiş ortalamaya girer ve ortalamayı düşürür. Program hata vermeden yanlış sonuç verir.
get() hatayı önler ama doğru varsayılan değeri sizin yerinize seçmez. Eksik alanın sizin probleminizde ne anlama geldiğine bakıp onu siz seçersiniz. Program hata vermedi diye veri doğru işlenmiş olmaz.
Veri işleme akışını parçalamak
Küçük bir veri problemine şu sırayla yaklaşabilirsiniz:
veriyi tanı
    ↓
hangi kayıtlar gerekli?
    ↓
hangi alanlar kullanılacak?
    ↓
filtrele / say / biriktir / maksimumu bul / grupla
    ↓
sonucu açık bir yapıda döndür
Bütün bu adımları tek bir fonksiyona yığmayın. İşi gecen_ogrenciler, puan_ortalamasi ve en_yuksek_puanli gibi, her biri tek iş yapan fonksiyonlara bölün. Böylece her parçayı ayrı ayrı deneyebilirsiniz.
Hepsi bir arada: kantinin akşam raporu
Okul kantininde her satış için bir fiş kesiliyor. Fişte ürünün adı, kategorisi ve tutarı yazıyor. Bugünkü fişler şunlar:
| Fiş | Ürün | Kategori | Tutar |
|---|---|---|---|
| 1 | Kalem | Kırtasiye | 120 TL |
| 2 | Su | Büfe | 15 TL |
| 3 | Defter | kırtasiye | 80 TL |
| 4 | Tost | Büfe | (boş) |
| 5 | Silgi | KIRTASİYE | 30 TL |
Kantin sorumlusu her akşam bu fişlerden bir rapor hazırlıyor. Kırtasiye fişlerini ayrı bir kutuya ayırıyor. Rapora günün toplam satışını, fiş başına ortalama tutarı, günün en büyük satışını ve her kategorinin toplam satışını yazıyor. Bu raporu artık bir program hazırlayacak.
Fişlerde programı zorlayacak durumlar var. Kategori sütununda aynı kategori üç biçimde yazılmış: Kırtasiye, kırtasiye ve KIRTASİYE. Tost fişinin tutarı boş. Kantinin hiç açılmadığı bir gün hiç fiş olmaz, ortalama da hesaplanamaz. Müdür de en büyük satışın hangi ürün olduğunu sorabilir. Aşağıdaki tablo raporun adımlarını ve bu durumları Türkçe adımıyla ve Python karşılığıyla yan yana koyuyor.
| Durum | Türkçe adım | Python’da | Dikkat |
|---|---|---|---|
| Bir fişin tutarını okumak | “3. fişin tutar sütununa bak” | fisler[2]["tutar"] |
Önce kayıt, sonra alan seçilir. İndeks 0’dan başlar |
| Kırtasiye fişlerini ayırmak | “Kırtasiye fişlerini ayrı bir kutuya koy” | kirtasiye.append(fis) |
append() fişin kendisini koyar, fotokopisini almaz. Kutudaki fişi düzeltirseniz asıl listedeki fiş de değişir. Fotokopi için fis.copy() |
| Üç ayrı kırtasiye yazımı | “Kategorisi aynı olan fişleri topla” | toplamlar[kategori] = toplamlar.get(kategori, 0) + tutar |
Normalleştirme yoksa üç ayrı satır çıkar. strip().lower() boşluk ve büyük harf farkını giderir, ama KIRTASİYE’yi kırtasiye yapmaz |
| Tutarı boş Tost fişi | “Tutar yoksa 0 say” | fis.get("tutar", 0) |
0 koyarsanız fiş sayılır ve ortalama düşer. Fişi ortalamaya katıp katmayacağınıza siz karar verirsiniz |
| Hiç fiş yok | “Fiş yoksa ortalama yazma” | if len(fisler) == 0: return None |
0 döndürürseniz “satış yok” ile “ortalama 0 TL” ayrımı kaybolur. Kontrol yoksa bölme ZeroDivisionError verir |
| En büyük satış hangi ürün? | “En büyük tutarı not al” | en_buyuk = fis |
Yalnız tutarı tutarsanız ürünün adı kaybolur. Kaydın tamamı tutulur |
Program yalnız yazılan adımı uygular. append() fişin kendisini ekler: ayrı bir kopya gerekiyorsa copy() açıkça yazılır. Kategori sütunundaki üç yazımı tek satırda toplayan bir kural yazılmazsa program da onları ayrı sayar.
Değiştir: rapora yeni alan ekleyin
Aşağıdaki kod her kayda gecti adında yeni bir alan ekliyor. Çalıştırmadan önce son satırın ne yazacağını söyleyin.
Bu kod listedeki sözlüklerin kendisini değiştirir, kopya almaz. Bu kayıtları daha önce gecenler.append(ogrenci) ile başka bir listeye eklemiş olsaydınız yeni gecti alanını o listede de görürdünüz. Asıl veri değişmemeliyse ogrenci.copy() ile kopya alıp onu değiştirin ya da her kayıt için yeni bir sözlük oluşturun.
Kodu, gecti yerine durum adında bir alan ekleyecek biçimde değiştirin: puanı 60 ve üzeriyse "geçti", değilse "kaldı" olsun.
Üret: kantinin kategori toplamları
Kantin raporundaki kategori toplamlarını yazın. kategori_toplamlari fonksiyonu her kategorinin toplam satışını bir sözlükte döndürmeli. Kategori adları farklı yazılmış olabilir: anahtarı oluşturmadan önce strip() ve lower() ile normalleştirin. Bu verideki kategorilerde I ya da İ harfi yok, bu yüzden lower() yeterli.
Beklenen sonuç iki anahtarlı bir sözlüktür: kırtasiye için 230, büfe için 75.
Döngü içinde önce kategori = fis["kategori"].strip().lower() yazın. Sonra toplamlar[kategori] = toplamlar.get(kategori, 0) + fis["tutar"] kullanın.
def kategori_toplamlari(fisler):
    toplamlar = {}

    for fis in fisler:
        kategori = fis["kategori"].strip().lower()
        toplamlar[kategori] = toplamlar.get(kategori, 0) + fis["tutar"]

return toplamlarTek sayfa özet
- Bir kaydı sözlükte, kayıtların hepsini bir listede tutarız.
liste[indeks]["alan"]önce kaydı, sonra alanı seçer.- Filtreleme, koşulu sağlayan kayıtları yeni bir listeye eklemektir.
append(ogrenci)sözlüğü kopyalamaz; iki liste aynı sözlüğü paylaşır. - Ayrı bir kayıt gerekiyorsa
ogrenci.copy()kullanılır. Değerleri sayı ve metin olan kayıtlar için bu sığ kopya yeterlidir. - Özetlemede bir alanın değerleri sayılır ya da toplanır.
- Liste boşsa
Nonedöndürmek, “veri yok” durumunu gerçekten0olan bir sonuçtan ayırır. - Maksimum aramada en büyük sayıyla birlikte o sayının ait olduğu kayıt da tutulabilir.
>ile karşılaştırınca eşitlikte ilk bulunan kayıt kalır. Noneile başlayan kalıptaen_yuksek is None or ...koşulu ilk turda sağ tarafı hesaplamaz (kısa devre).- Gruplamada grup adı sözlüğün anahtarı olur. Değer o grubun sayısı, toplamı ya da kayıtlarını tutan bir listedir. Liste tutarken grup ilk kez geldiğinde önce boş liste konur, sonra kayıt eklenir.
- Metin alanlarında gruplamanın sonucu seçilen normalleştirme kuralına bağlıdır.
strip().lower()boşluk ve büyük harf farkını giderir, ama TürkçeIveİharflerini Türkçe kurala göre küçültmez. get(grup, 0)bir grubun sayacını ya da toplamını başlatmak için kullanışlıdır. Eksik bir alanın varsayılan değerini ise o alanın probleminizde ne anlama geldiği belirler: tutarı boş bir fişe0yazmak ortalamayı düşürür.- Veri işleme kodunu tek iş yapan küçük fonksiyonlara bölerseniz her parçayı ayrı ayrı sınayabilirsiniz.
- Kantin raporundaki her adım bu kalıplardan biridir: fişleri ayırmak filtreleme, toplam ve ortalama özetleme, en büyük satış maksimum arama, kategori toplamları gruplamadır.
Bir sonraki bölümde bu kayıtları bir dosyadan okuyacak, sonuçları dosyaya yazacağız: konu dosyalar ve CSV.
Bu bölümün kazanımları
Bu bölümü bitiren öğrenci:
liste[indeks]["alan"]erişimini iki adımda çözümler.- Filtreleme kalıbını kurar ve
append()in kaydı kopyalamadığını açıklar. - Kayıtlar üzerinde sayma ve biriktirmeyle özet çıkarır.
- Maksimum aramada en büyük değerle birlikte o değerin ait olduğu kaydı tutar.
- Kayıtları bir alana göre gruplar; her grubun sayısını, toplamını ya da kayıtlarını bir sözlükte tutar.
- Metin alanlarında normalleştirme kuralının gruplama sonucunu belirlediğini açıklar.
- Kayıt listesinde eksik alanın toplamı ve ortalamayı nasıl değiştirdiğini hesaplar ve varsayılan değeri problemin kuralına göre seçer.