String işlemleri
Programlarda birçok veri sayı değildir: adlar, e-posta adresleri, ürün kodları, şehir adları, dosya adları ve kullanıcı mesajları metin olarak tutulur. Python’da metin değerleri str türündedir.
Bu hafta bir string’in karakterlerine erişmeyi, parçalarını almayı, metni temizlemeyi ve basit doğrulamalar yapmayı öğreneceğiz. Amaç çok sayıda string metodunu ezberlemek değil; metni adım adım dönüştürme ve kontrol etme alışkanlığı kazanmaktır.
Bu bölümün kapsamı
- indeks ve negatif indeksle karaktere erişim
- dilimlemede başlangıcın dâhil, bitişin hariç olması
- string’in değiştirilemez olması ve metotların yeni string üretmesi
strip(),lower(),upper()ve TürkçeI/İsınırıin,startswith()veendswith()denetimlerinin farkısplit()vejoin()ile parçalama ve birleştirme- f-string ile biçimlendirme ve
:.2fdavranışı
- düzenli ifadeler (
remodülü) - Unicode normalleştirme biçimleri
casefold()davranışının ayrıntıları
Bu başlıklar konunun devamıdır; ileride karşınıza çıkar ama bu derste ezberlemeniz beklenmiyor.
"İĞNE".lower() neden her zaman "iğne" vermez?
Metin işleme, gözle aynı görünen iki değerin program için aynı olmadığı yerde başlar. Baştaki bir boşluk, büyük harf farkı ya da Türkçe’ye özgü bir harf çifti karşılaştırmayı sessizce bozar.
String: karakterlerden oluşan bir değer
Aşağıdaki değişken bir string tutar:
sehir = "Samsun"Karakterleri soldan sağa düşünelim:
S  a  m  s  u  n
0  1  2  3  4  5
Python’da indeksler 0’dan başlar.
sehir = "Samsun"

print(sehir[0])
print(sehir[1])
print(sehir[5])
Çıktı:
S
a
nAltı karakterlik bir string’in son geçerli pozitif indeksi 5tir. sehir[6] yazmak IndexError üretir.
len() ile uzunluk
len() string içindeki karakter sayısını verir:
sehir = "Samsun"
print(len(sehir))
Sonuç 6dır.
İndeks ile uzunluk arasında önemli bir ilişki vardır:
uzunluk = 6
son indeks = 5
Bu nedenle son karaktere pozitif indeksle ulaşmak için len(metin) - 1 kullanılabilir:
metin = "Python"
print(metin[len(metin) - 1])
Python bunun için daha kısa bir yol da sunar: hemen aşağıda göreceğimiz negatif indeksleme ile son karakter metin[-1] biçiminde alınabilir.
Negatif indeksler
Negatif indeksler sağdan sayar:
metin = "Python"

print(metin[-1])
print(metin[-2])
Çıktı:
n
o
-1 son karakteri gösterir.
Tahmin et — hangi karakterler yazılır?
Kodu çalıştırmadan önce sonucu tahmin edin:
Sonra hücreyi çalıştırıp tahmininizi doğrulayın.
Dilimleme (slicing)
Bir string’in yalnızca bir karakterini değil, bir bölümünü de alabiliriz:
metin = "Programlama"

print(metin[0:7])
Sonuç:
ProgramDilimlemede başlangıç indeksi dahil, bitiş indeksi hariçtir.
metin[0:7]
      ↑ ↑
      | └─ 7 dahil değil
      └─── 0 dahil
Başlangıç veya bitiş boş bırakılabilir:
dosya = "rapor.pdf"

print(dosya[:5])
print(dosya[6:])
Çıktı:
rapor
pdf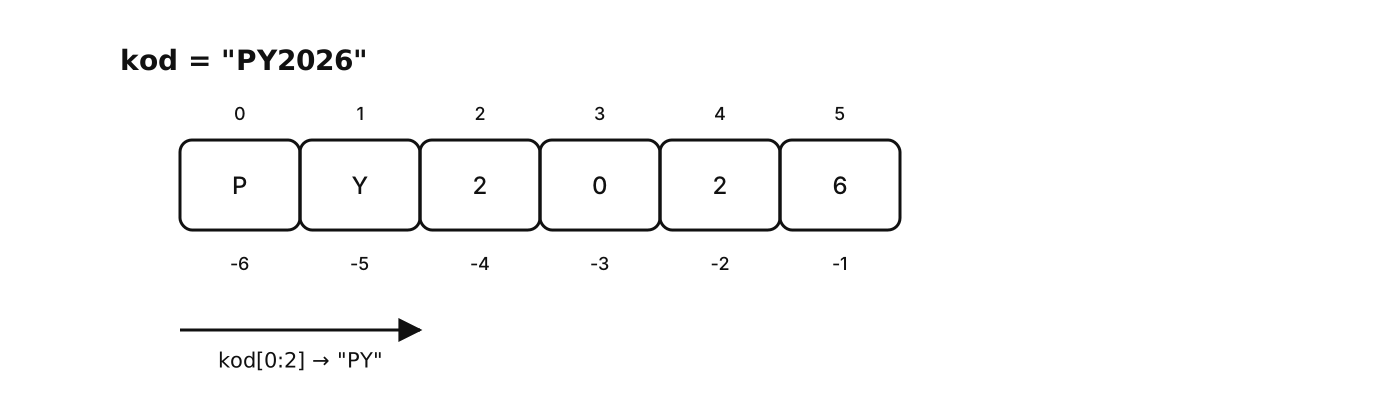
Alıştırma — ders kodunu parçalayın
"BLP101" değerinden ilk üç karakteri ve son üç karakteri ayrı değişkenlere alın.
Beklenen çıktı:
BLP
101
İlk üç karakter için ders_kodu[:3], son üç karakter için ders_kodu[-3:] kullanılabilir.
ders_kodu = "BLP101"

bolum = ders_kodu[:3]
numara = ders_kodu[-3:]

print(bolum)
print(numara)
String değerler değiştirilemez
Bir listenin elemanını daha sonra değiştirebileceğimizi gelecek hafta göreceğiz. String değerlerde ise tek bir karakteri doğrudan değiştiremeyiz:
metin = "kedi"
# metin[0] = "K"   # Bu işlem geçerli değildir.
Bunun yerine yeni bir string üretiriz:
metin = "kedi"
yeni_metin = "K" + metin[1:]

print(yeni_metin)
String’in değiştirilemez (immutable) olması, bir string metodunun da mevcut değeri yerinde değiştirmek yerine yeni değer üretmesi anlamına gelir.
lower(), upper() ve strip()
Metin karşılaştırmalarında büyük-küçük harf ve gereksiz boşluklar sorun çıkarabilir.
girdi = "  Python  "

temiz = girdi.strip()
kucuk = temiz.lower()

print(temiz)
print(kucuk)strip()baştaki ve sondaki boşlukları kaldırır.lower()harfleri Unicode’un genel küçük harf dönüşüm kurallarına göre dönüştürür.upper()harfleri Unicode’un genel büyük harf dönüşüm kurallarına göre dönüştürür.
Önemli nokta:
metin = "Python"
metin.lower()

print(metin)
Burada metin hâlâ "Python"dır. Çünkü lower() yeni bir string üretir. Sonucu saklamak gerekir:
metin = metin.lower()Türkçe I / İ için önemli uyarı
Python’ın str.lower() ve str.upper() metotları işletim sisteminin Türkçe yerel ayarını takip ederek çalışan “Türkçe küçük/büyük harf” fonksiyonları değildir. Unicode’un locale-independent dönüşümlerini uygular. Türkçedeki noktalı/noktasız i çifti nedeniyle bu fark gerçek veride önemlidir.
Örneğin:
print("İĞNE".lower())
print("iğne" == "İĞNE".lower())
print("ISPARTA".lower())
print("istanbul".upper())
Python’da tipik sonuçların mantığı şöyledir:
"İĞNE".lower()      -> "i̇ğne"
"iğne" == ...       -> False
"ISPARTA".lower()   -> "isparta"
"istanbul".upper()  -> "ISTANBUL"
İlk sonuç ekranda iğne gibi görünebilir; ancak ilk i karakterinden sonra birleşen nokta (U+0307) bulunur. Bu nedenle iki metin görsel olarak çok benzer olsa da eşit olmayabilir ve karakter sayıları bile farklı çıkabilir.
Türkçe yazım kuralına göre ise:
I→ıİ→ii→İı→I
olması beklenir.
casefold() büyük/küçük harf duyarsız karşılaştırmalar için daha güçlü bir Unicode aracıdır; fakat Türkçe yerel ayarına özgü I / İ problemini tek başına çözmez. Bu nedenle “lower() yerine her zaman casefold() yazarsam Türkçe düzelir” sonucu çıkarılmamalıdır.
İş kuralınız gerçekten Türkçe büyük/küçük harf eşdeğerliği gerektiriyorsa dönüşümü açıkça tanımlayabilirsiniz:
def turkce_kucult(metin):
    donusum = str.maketrans({"I": "ı", "İ": "i"})
    return metin.translate(donusum).lower()

assert turkce_kucult("İĞNE") == "iğne"
assert turkce_kucult("ISPARTA") == "ısparta"
Bu yardımcı fonksiyon, önce Türkçeye özgü iki büyük harfi dönüştürür; sonra kalan harfler için normal lower() kullanır.
Buradaki amaç her metni zorla Türkçeleştirmek değildir. E-posta alan adları, programlama tanımlayıcıları veya uluslararası kodlar farklı normalleştirme kurallarına sahip olabilir. Önce verinin hangi dil/iş kuralına göre karşılaştırılacağını belirleyin, sonra dönüşümü seçin.
İncele ve düzelt — temizlenmiş kullanıcı adı
Aşağıdaki kod kullanıcı adını temizlemek istiyor, fakat metodun dönüş değerini saklamıyor:
Çıktının deniz olması için kodu düzeltin.
kullanici_adi = kullanici_adi.strip().lower() yazabilirsiniz.
kullanici_adi = "  DENIZ  "
kullanici_adi = kullanici_adi.strip().lower()

print(kullanici_adi)
in ile içerme kontrolü
Bir string’in başka bir string içerip içermediğini in ile kontrol edebiliriz:
eposta = "[email protected]"

print("@" in eposta)
print("omu.edu.tr" in eposta)
print("gmail.com" in eposta)
Sonuçlar bool türündedir.
Ancak “içeriyor mu?” ile “tam olarak bu biçimde mi bitiyor?” aynı soru değildir. Örneğin:
dosya = "rapor.pdf.bak"

print(".pdf" in dosya)          # True
print(dosya.endswith(".pdf"))   # False
İkinci soru gerçek dosya uzantısı kontrolüne daha yakındır.
"@" in eposta sonucu True olması, metnin geçerli bir e-posta adresi olduğunu kanıtlamaz. Basit kontrolleri gerçek doğrulama ile karıştırmayın.
Amaç odaklı metotlar: startswith(), endswith(), replace()
Belirli bir niyet için genel in kontrolünden daha açık metotlar vardır:
dosya = "rapor.pdf"

print(dosya.startswith("rapor"))
print(dosya.endswith(".pdf"))startswith(...): metin verilen başlangıçla mı başlıyor?endswith(...): metin verilen sonla mı bitiyor?
Bir alt metni başka bir metinle değiştirmek için replace() yeni bir string üretir:
telefon = "0555 123 45 67"
temiz = telefon.replace(" ", "")
print(temiz)
Çıktı:
05551234567String’ler değiştirilemez olduğu için replace() de mevcut string’i yerinde değiştirmez; sonucu saklamak gerekir.
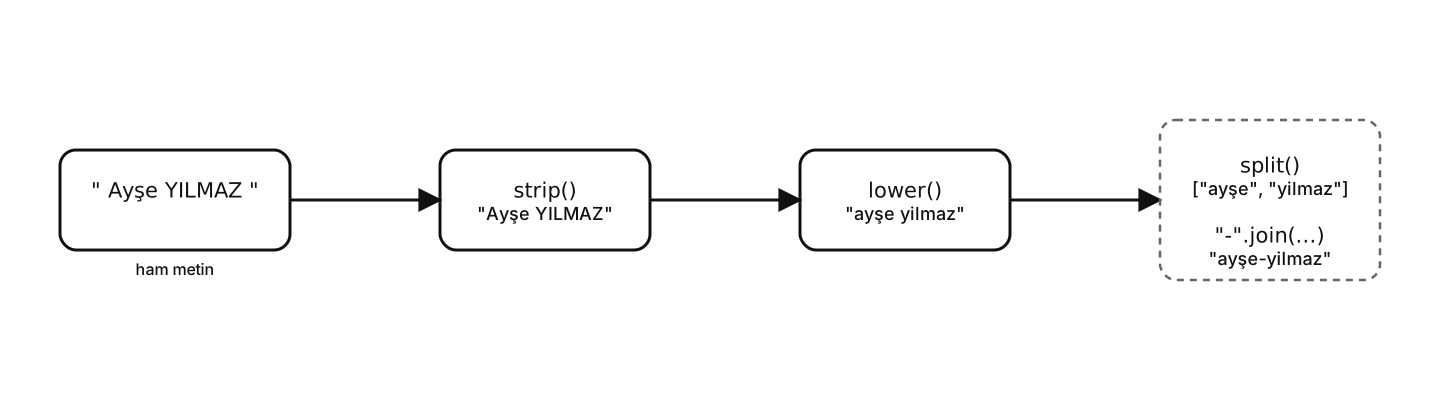
split() ile parçalama, join() ile birleştirme
Bir metni belirli ayraçlardan parçalara ayırmak için split() kullanılır:
satir = "kalem,defter,silgi"
parcalar = satir.split(",")

print(parcalar)
Çıktı:
['kalem', 'defter', 'silgi']Argüman verilmezse ardışık boşluklara göre kelimelere ayırmak için kullanılabilir:
cumle = "Python ile metin işleme"
print(cumle.split())
Ters yönde, birden fazla string parçayı belirli bir ayraçla birleştirmek için join() kullanılır:
kelimeler = ["Python", "ile", "metin", "işleme"]
sonuc = " ".join(kelimeler)
print(sonuc)
Çıktı:
Python ile metin işlemejoin() çağrısında soldaki string, parçaların arasına konacak ayraçtır.
split(","), basit ve kontrollü metinlerde yararlıdır; fakat gerçek CSV dosyalarını ayrıştırmanın güvenilir genel çözümü değildir. CSV alanının içinde virgül veya tırnaklı metin bulunabilir. 12. haftada bunun için Python’ın csv modülünü kullanacağız.
String ve döngüler
Bir string üzerinde for ile karakter karakter gezebiliriz:
metin = "Python"

for karakter in metin:
    print(karakter)
Örneğin bir metindeki ASCII rakamlarını sayalım:
kod = "BLP101"
rakam_sayisi = 0

for karakter in kod:
    if karakter >= "0" and karakter <= "9":
        rakam_sayisi = rakam_sayisi + 1

print(rakam_sayisi)
Burada "BLP101" içinde üç rakam vardır.
Python’da hazır .isdigit() metodu da vardır:
print("7".isdigit())
print("A".isdigit())
Bu metot tek karakterde kullanılabildiği gibi bütün bir string’in rakamlardan oluşup oluşmadığını da sınayabilir:
print("101".isdigit())  # True
print("10A".isdigit()) # False.isdigit() Unicode’daki bazı ASCII dışı rakam karakterleri için de True döndürebilir. İş kuralınız yalnızca 0–9 ASCII rakamlarını kabul ediyorsa "0" <= karakter <= "9" gibi açık kontrol daha dar bir sözleşmedir. Hazır metodun varlığını bilmek ile hangi sözleşmenin gerektiğini seçmek ayrı becerilerdir.
Alıştırma — belirli karakteri sayın
Bir ürün kodunda kaç tane - karakteri bulunduğunu sayın.
Beklenen sonuç 3tür.
if karakter == "-": koşulu içinde tire_sayisi değerini artırın.
urun_kodu = "TR-55-A-20"
tire_sayisi = 0

for karakter in urun_kodu:
    if karakter == "-":
        tire_sayisi = tire_sayisi + 1

print(tire_sayisi)
f-string ile okunabilir çıktı
Değişkenleri metne yerleştirmenin okunabilir yollarından biri f-string kullanmaktır:
ad = "Deniz"
puan = 82

mesaj = f"{ad} adlı öğrencinin puanı: {puan}"
print(mesaj)
Süslü parantezlerin içine ifadeler de yazılabilir:
fiyat = 120
adet = 3

print(f"Toplam: {fiyat * adet} TL")
Sayıyı iki ondalık basamakla göstermek
- haftadaki yakıt veya para hesaplarında
994.2400000000001gibi uzunfloatçıktıları görebileceğimizi söylemiştik. F-string içinde.2f, sayıyı iki ondalık basamakla gösterir:
tutar = 994.2400000000001
print(f"Toplam: {tutar:.2f} TL")
Çıktı:
Toplam: 994.24 TLBaşka bir örnek:
oran = 3.5
print(f"Oran: {oran:.2f}")
Çıktı Oran: 3.50 olur.
.2f esas olarak gösterim biçimidir. tutar değişkenindeki float değeri string’e yazdırırken iki basamakla biçimlendirir; bilgisayarın içindeki kayan noktalı temsili kesin ondalık sayıya dönüştürmez. Testlerde sayısal tolerans konusunu 7. haftada bu yüzden ayrıca ele aldık.
Başlangıçta f-string’i özellikle çıktı üretirken kullanacağız. Karmaşık hesaplamaları süslü parantezlerin içine doldurmak yerine ayrı değişkenlerde hesaplamak çoğu zaman daha okunurdur.
Fonksiyonlarla metin normalleştirme
Aynı temizleme işlemini tekrar kullanacaksak fonksiyon yazabiliriz:
def kullanici_adi_temizle(metin):
    return metin.strip().lower()

assert kullanici_adi_temizle("  DENIZ ") == "deniz"
assert kullanici_adi_temizle("Ayse") == "ayse"
Bu örnekte yalnızca ASCII harfli kullanıcı adları kullandık. Türkçe ürün/kişi/şehir adlarını büyük-küçük harf duyarsız eşleştirecek bir normalleştirme gerekiyorsa yukarıdaki Türkçe I / İ kuralı ayrıca dikkate alınmalıdır.
Bu fonksiyon saf bir dönüşüm yapar: string alır, yeni string döndürür.
Üret — basit kurumsal e-posta kontrolü
Bir metnin:
- Başında ve sonunda boşluk varsa temizlenmesini,
- Küçük harfe çevrilmesini,
- İçinde
@bulunmasını, omu.edu.trifadesiyle bitmesini
kontrol eden kurumsal_eposta_mi fonksiyonunu yazın.
Başlangıç:
Beklenen çıktı:
True
False
Örneğin temiz = eposta.strip().lower() ile başlayabilirsiniz. Sonra "@" in temiz ve temiz.endswith("omu.edu.tr") koşullarını and ile birleştirin.
def kurumsal_eposta_mi(eposta):
    temiz = eposta.strip().lower()
    return "@" in temiz and temiz.endswith("omu.edu.tr")

print(kurumsal_eposta_mi("  [email protected] "))
print(kurumsal_eposta_mi("[email protected]"))Bu fonksiyon yalnızca ders için basitleştirilmiş bir kontroldür. Gerçek e-posta adresi doğrulaması için daha ayrıntılı kurallar gerekir.
Tek sayfa özet
Bu hafta string değerleri yalnızca ekrana yazdırılan metinler olarak değil, işlenebilir veri olarak kullandık.
- String indeksleri
0’dan başlar. - Negatif indeksler sağdan erişim sağlar; son karakter
metin[-1]ile alınabilir. len()karakter sayısını verir.- Dilimlemede başlangıç dahil, bitiş hariçtir.
- String değerler değiştirilemez; metotlar yeni string üretir.
strip(),lower()veupper()sık kullanılan normalleştirme araçlarıdır;lower()/upper()Türkçe yerel ayarına özgüI/İdönüşümünü otomatik yapmaz.casefold()genel harf-duyarsız karşılaştırmada yararlı olsa da Türkçe yerel dönüşüm sorununu tek başına çözmez.inbasit içerme kontrolü yapar;startswith()veendswith()başlangıç/bitiş niyetini daha açık ifade eder.replace()bir alt metni başka bir metinle değiştirerek yeni string üretir.split()metni parçalara ayırır,join()string parçaları bir ayraçla birleştirir.- String üzerinde
forile karakter karakter gezilebilir;.isdigit()hazır rakam kontrolüdür. - F-string, değişkenleri okunabilir biçimde çıktıya yerleştirir;
:.2fsayıyı iki ondalık basamakla gösterir. - Metin temizleme ve kontrol işlemleri fonksiyonlara ayrılabilir.
Bir sonraki bölümde birden fazla değeri birlikte tutmak için listeler ve demetler kullanacağız.
Bu bölümün kazanımları
Bu bölümü bitiren öğrenci:
- İndeks ve negatif indeksle karaktere erişir.
- Dilimlemede başlangıcın dâhil, bitişin hariç olduğunu uygular.
- String’in değiştirilemez olduğunu ve metotların yeni string ürettiğini gösterir.
strip(),lower()veupper()ile normalleştirir; TürkçeI/İsınırını bilir.in,startswith()veendswith()denetimlerini ayırır.split()vejoin()ile metni parçalar ve birleştirir.- F-string ile biçimlendirir ve
:.2fdavranışını açıklar.